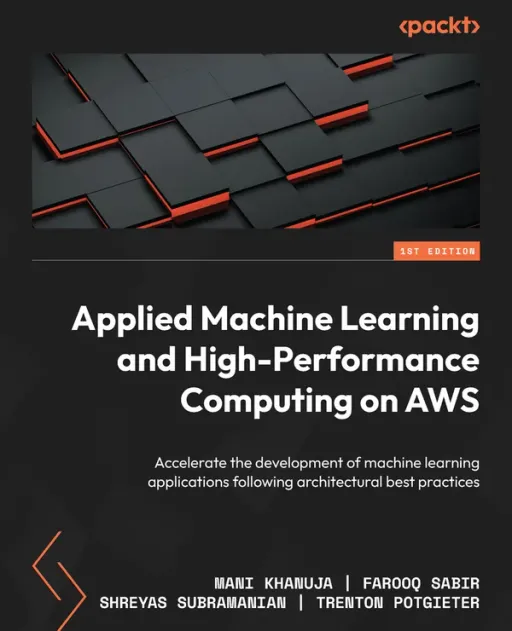
Applied Machine Learning and High-Performance Computing on AWS
Mani Khanuja, Farooq Sabir, Shreyas Subramanian, Trenton Potgieter
- Editorial
- Packt
- Año
- 2022
- Páginas
- ~394
- Nivel
- Intermedio
De qué trata
Guía técnica especializada publicada por Packt a finales de 2022 que vincula las arquitecturas de computación de alto rendimiento (HPC) con los flujos de trabajo de Machine Learning e Inteligencia Artificial en Amazon Web Services. Está orientada a científicos de datos, ingenieros de aprendizaje automático y especialistas en HPC de nivel intermedio que ya dominan Python y los fundamentos de Deep Learning con PyTorch o TensorFlow, pero que necesitan escalar sus modelos más allá de una máquina local hacia clústeres elásticos y distribuidos en la nube.
El contenido profundiza en las infraestructuras de cómputo y redes avanzadas de AWS: redes ultra rápidas con Elastic Fabric Adapter (EFA), sistemas de archivos paralelos de alto rendimiento con Amazon FSx for Lustre e instancias aceleradas por GPU y chips dedicados (como AWS Trainium e Inferentia). Enseña a procesar conjuntos masivos de datos utilizando Apache Spark en Amazon EMR, ejecutar entrenamiento distribuido (tanto paralelismo de datos como de modelo) mediante las librerías nativas de Amazon SageMaker, y desplegar endpoints de inferencia optimizados de baja latencia con Triton Inference Server, así como la exportación a entornos perimetrales con AWS IoT Greengrass.
A través de 14 capítulos prácticos respaldados por cuadernos Jupyter, se desarrollan casos de uso reales de alta exigencia computacional: entrenamiento de Vision Transformers a escala, simulación de dinámica de fluidos computacional (CFD), tuberías de procesamiento genómico y analítica de vehículos autónomos. El libro destaca por abordar problemas de cuello de botella en I/O y sincronización de gradientes entre nodos distribuidos; sin embargo, no profundiza en el diseño básico de algoritmos clásicos de ML ni en interfaces web de usuario, concentrándose puramente en rendimiento y escalabilidad de infraestructura. Es necesario contar con experiencia previa en Python y comandos de terminal Linux.
- AWS
- Machine Learning
- High-Performance Computing (HPC)
- Amazon SageMaker
- Amazon EMR
- Apache Spark
- Amazon FSx for Lustre
- Entrenamiento distribuido
- PyTorch
- Deep Learning
- Inferencia
¿Cómo enseña?
Teoría + práctica
- ✓ Incluye ejercicios
- ✓ Incluye proyectos
Proyectos
Entrenamiento distribuido de Vision Transformers (ViT)
Entrenamiento de modelos de visión artificial a gran escala en clústeres multi-GPU utilizando Amazon SageMaker Distributed Training y Amazon FSx for Lustre para evitar cuellos de botella en I/O.
Pipeline de análisis genómico y simulación científica
Flujo de trabajo distribuido para procesar secuencias de ADN y cálculos numéricos masivos integrando Apache Spark en Amazon EMR y AWS Batch.
Sistema de inferencia optimizado en nube y borde
Despliegue de modelos para inferencia de baja latencia mediante Triton Inference Server en endpoints de SageMaker y distribución en dispositivos periféricos con AWS IoT Greengrass.