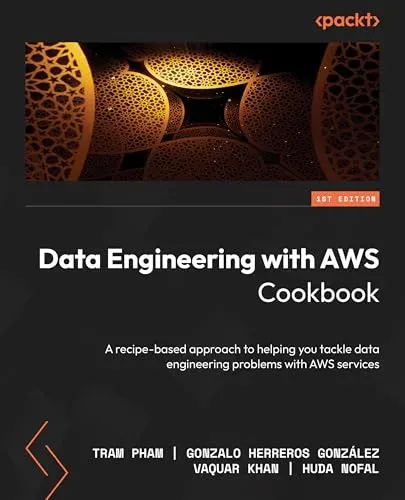
Data Engineering with AWS Cookbook
Tram Ngoc Pham
- Editorial
- Packt
- Año
- 2024
- Páginas
- ~922
- Nivel
- Intermedio
De qué trata
Manual práctico en formato recetario centrado en resolver los desafíos diarios de diseño, gobernanza, automatización y escalabilidad en plataformas de datos corporativas sobre Amazon Web Services. Publicado a finales de 2024 por Trâm Ngọc Phạm junto a especialistas en datos del ecosistema AWS, el texto está dirigido a ingenieros de datos, arquitectos de soluciones y profesionales cloud de nivel intermedio que ya cuentan con soltura en SQL, Python y los fundamentos de la nube, y buscan implementar soluciones robustas y reproducibles en entornos de producción.
El recorrido enseña a construir data lakes modernos y flujos analíticos empleando el catálogo nativo de AWS. Cubre el almacenamiento y particionado eficiente en Amazon S3, el intercambio seguro de datos entre cuentas con AWS Lake Formation y la ingesta y transformación ETL mediante AWS Glue, Glue Studio y Glue Data Quality. En el procesamiento a gran escala se profundiza en Amazon EMR, EMR Serverless y la optimización de Apache Spark, mientras que la orquestación de canalizaciones se aborda con AWS Step Functions, Amazon EventBridge y Amazon MWAA (Managed Workflows for Apache Airflow). Asimismo, examina el gobierno distribuido bajo arquitecturas Data Mesh con AWS DataZone, el diseño de capas de consulta y servicio con Amazon Redshift, Amazon Athena y Amazon QuickSight, y la migración de sistemas heredados con AWS DMS y AWS SCT.
La obra estructura su contenido a través de recetas independientes y modulares acompañadas de scripts y plantillas de Infrastructure as Code (IaC) con DevOps y CI/CD, sin desarrollar un único proyecto monolítico de inicio a fin. Su gran virtud radica en la actualización técnica hacia servicios nativos modernos como DataZone y EMR Serverless, cubriendo aspectos críticos como la detección de datos sensibles (PII) y el control de calidad automático. Como contrapartida, no enseña fundamentos de programación ni sintaxis básica de Spark o SQL, y requiere vigilar los costes de aprovisionamiento en AWS al replicar recetas con clústeres reales.
- AWS Glue
- Amazon S3
- Amazon EMR
- Amazon Redshift
- Amazon Athena
- Apache Spark
- AWS Lake Formation
- AWS DataZone
- AWS Step Functions
- Apache Airflow (MWAA)
- AWS DMS
- Data Governance
¿Cómo enseña?
Con ejercicios
- ✓ Incluye ejercicios
- ✗ Sin proyectos