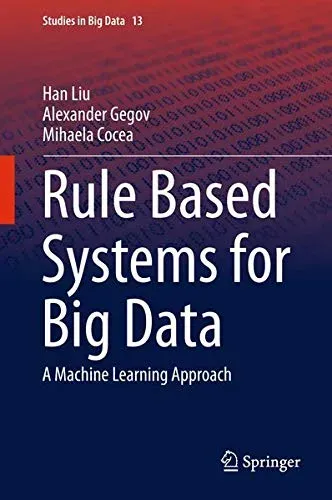
Rule Based Systems for Big Data
Alexander Gegov, Han Liu, Mihaela Cocea
- Editorial
- Springer
- Año
- 2015
- Páginas
- ~121
- Nivel
- Intermedio
De qué trata
Monografía académica y especializada publicada por Springer dentro de la colección Studies in Big Data, centrada en la convergencia entre los sistemas basados en reglas (sistemas expertos) y las técnicas de aprendizaje automático orientadas al procesamiento de grandes volúmenes de datos. No aborda una versión de software comercial o framework específico, sino los fundamentos teóricos y algorítmicos necesarios para inducir, simplificar y estructurar reglas a partir de datos reales masivos. Está orientada a investigadores, científicos de datos y estudiantes de posgrado de nivel intermedio o avanzado que cuenten con conocimientos sólidos en teoría de la computación, probabilidad, álgebra lineal y lógica simbólica, y que busquen alternativas explicables a los modelos de caja negra.
El contenido expone un marco metodológico unificado dividido en tres fases críticas: la generación de reglas de clasificación mediante estrategias divide-and-conquer y separate-and-conquer (analizando algoritmos clásicos y variantes como ID3, Prism y métodos basados en entropía de la información), la simplificación y poda de conjuntos de reglas para optimizar la generalización y mitigar el sobreajuste, y los esquemas de representación formal del conocimiento. Asimismo, profundiza en técnicas de aprendizaje por ensambles (ensemble learning) para combinar múltiples bases de reglas y robustecer la capacidad predictiva, evaluando de forma rigurosa el equilibrio entre precisión, eficiencia computacional e interpretabilidad mediante conceptos derivados de la teoría de la información y la teoría de sistemas.
El mayor valor del libro reside en fundamentar matemáticamente la inteligencia artificial explicable (XAI) en escenarios de Big Data, demostrando cómo extraer conocimiento transparente sin sacrificar rendimiento. Al ser una monografía puramente conceptual y formal, no incluye código fuente descargable, entornos de laboratorio ni implementaciones en plataformas como Apache Spark o Hadoop. Es una obra de consulta indispensable para quienes diseñan arquitecturas de motores de inferencia o algoritmos de minería de datos, aunque quien busque implementaciones prácticas deberá trasladar las formulaciones matemáticas a su propio entorno de programación.
- Sistemas basados en reglas
- Big Data
- Machine Learning
- Algoritmo ID3
- Algoritmo Prism
- Entropía de la información
- Ensemble Learning
- Poda de reglas
- Inteligencia artificial explicable
- Árboles de decisión
- Minería de datos
¿Cómo enseña?
Teórico
- ✗ Sin ejercicios
- ✗ Sin proyectos