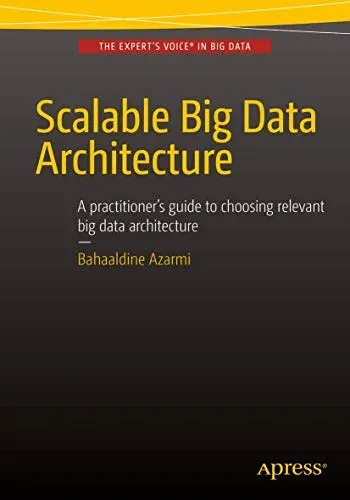
Scalable Big Data Architecture
Bahaaldine Azarmi
- Editorial
- Apress
- Año
- 2015
- Páginas
- ~141
- Nivel
- Intermedio
De qué trata
Manual práctico escrito por Bahaaldine Azarmi enfocado en la concepción y ensamblaje de arquitecturas de datos escalables para procesar altos volúmenes y velocidades de información (basado en el stack de big data y streaming de 2015-2016). La obra está dirigida a ingenieros de software, arquitectos de sistemas y desarrolladores de nivel intermedio que ya manejan conceptos básicos de desarrollo backend y buscan aprender cómo integrar distintas tecnologías independientes en una arquitectura coherente, inspirada en los principios del patrón Lambda.
El autor desglosa cada capa de la arquitectura tecnológica: la persistencia rápida y distribuida con Couchbase (cubriendo replicación cross-datacenter XDCR y caché) y Elasticsearch para búsquedas de texto y agregaciones analíticas; el desacoplamiento y transporte de flujos de eventos mediante Apache Kafka; el procesamiento y transformación en tiempo real con Apache Spark (Spark Streaming, estructuras RDD e indexación continua); la visualización interactiva de métricas e indicadores de negocio mediante Kibana; y la incorporación de algoritmos de clasificación y predicción con Spark MLlib sobre los datos ingestados. Finaliza abordando la gestión operativa, monitorización con la suite de Elastic y el empaquetado de componentes en contenedores Docker.
El libro enseña a través de la construcción gradual de un sistema completo de análisis de clics de usuarios (clickstream analytics), llevando al lector desde la generación de datos simulados hasta su visualización en cuadros de mando y modelado automático con machine learning. Destaca por su capacidad para materializar la teoría arquitectónica en una solución funcional y reproducible mediante contenedores. Quedan fuera aspectos de gestión de clústeres en producción física a gran escala y consideraciones avanzadas de seguridad empresarial, por lo que conviene disponer de conocimientos de Linux, nociones de Docker y familiaridad con lenguajes como Java o Scala.
- Arquitectura Lambda
- Apache Kafka
- Apache Spark
- Spark Streaming
- Elasticsearch
- Kibana
- Couchbase
- Spark MLlib
- Docker
- Clickstream Analytics
- Streaming de datos
¿Cómo enseña?
Con proyectos
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Pipeline integral de análisis clickstream en tiempo real
Sistema de procesamiento de eventos web que ingiere registros de clics con Apache Kafka, los procesa y limpia en tiempo real mediante Spark Streaming, los indexa en Elasticsearch para su visualización interactiva en Kibana, aplica modelos de machine learning con Spark MLlib y se despliega empaquetado en contenedores Docker.