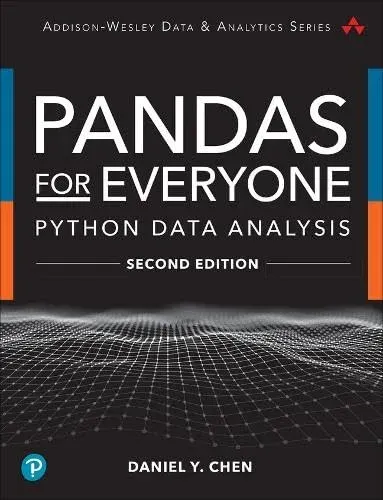
Pandas for Everyone, 2nd Edition
Daniel Y. Chen
- Editorial
- Addison Wesley
- Año
- 2023
- Páginas
- ~512
- Nivel
- Básico
De qué trata
La segunda edición de esta obra de referencia escrita por Daniel Y. Chen es una guía exhaustiva y metódica para aprender análisis y manipulación de datos en Python (cubriendo Python 3.9+ y las versiones modernas de Pandas). Está diseñada para principiantes absolutos en programación para ciencia de datos, analistas de negocio provenientes de Excel o SQL, estudiantes e investigadores de cualquier disciplina que necesiten limpiar y modelar datos tabulares sin requerir formación matemática avanzada ni experiencia previa en ingeniería de software.
El libro detalla el uso del ecosistema estándar de análisis de datos de Python, centrándose minuciosamente en las estructuras Series y DataFrame de Pandas. Enseña a estructurar datos bajo el paradigma de datos ordenados («tidy data»), técnicas de unión, concatenación y combinación («merge» y «concat»), y el ciclo de transformación split-apply-combine mediante `groupby`. Aborda en profundidad el tratamiento de valores perdidos, conversión de tipos de datos, manipulación de cadenas con expresiones regulares (`str`), gestión de fechas y series temporales (`datetime`), visualización exploratoria con Matplotlib y Seaborn, así como una introducción práctica al modelado estadístico y predictivo con Statsmodels y Scikit-Learn (regresión lineal, modelos lineales generalizados, análisis de supervivencia, regularización y clustering), además de un panorama introductorio a Geopandas, Dask y Altair.
El aprendizaje se articula a través de cuadernos de Jupyter reproducibles que trabajan con conjuntos de datos auténticos del mundo real (como estadísticas de salud pública del Banco Mundial, brotes epidemiológicos de Ébola o registros climáticos). Destaca sobre otros manuales por su rigor didáctico al explicar los fundamentos estructurales de los datos y prevenir errores frecuentes como la advertencia `SettingWithCopyWarning`; en contrapartida, no aborda optimizaciones a bajo nivel ni despliegue de modelos en entornos de producción. Es indispensable contar con un entorno de Jupyter Notebook o JupyterLab instalado para aprovechar al máximo sus cuadernos y ejercicios guiados.
- Python 3.9
- Pandas
- DataFrames
- Tidy Data
- Limpieza de datos
- GroupBy
- Seaborn
- Statsmodels
- Scikit-Learn
- Series temporales
- Jupyter Notebooks
- Análisis exploratorio
¿Cómo enseña?
Teoría + práctica
- ✓ Incluye ejercicios
- ✗ Sin proyectos