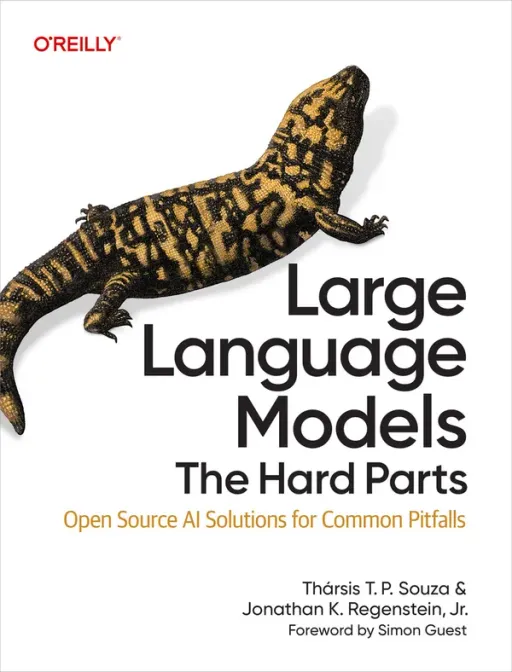
Large Language Models The Hard Parts
Tharsis T. P. Souza, Jonathan K. Regenstein Jr.
- Editorial
- O'Reilly
- Año
- 2026
- Páginas
- ~338
- Nivel
- Avanzado
De qué trata
Tratado de ingeniería de software en el que Tharsis T. P. Souza y Jonathan K. Regenstein Jr. desglosan los obstáculos operativos y arquitectónicos que surgen al llevar modelos de lenguaje grandes (LLMs) a producción a escala empresarial. Pensado para ingenieros de inteligencia artificial, arquitectos de software y líderes técnicos con experiencia previa en Python y en el consumo básico de APIs de LLMs, el texto se aleja deliberadamente de los tutoriales introductorios para resolver los problemas críticos de fiabilidad, rendimiento y cumplimiento normativo en entornos reales.
El núcleo del libro aborda los aspectos más espinosos del ciclo de desarrollo con LLMs: cómo cerrar la brecha de evaluación ('evals gap') reemplazando revisiones empíricas por pruebas automatizadas con herramientas de código abierto como DeepEval y Ragas; la gestión eficiente de ventanas de contexto extensas y sistemas de recuperación aumentada (RAG); el control estricto de salidas estructuradas en formatos como JSON para evitar alucinaciones sintácticas; la seguridad y moderación mediante técnicas de red-teaming (utilizando benchmarks como HarmBench); y las estrategias prácticas de alineamiento, fine-tuning y despliegue local de modelos abiertos con motores de inferencia de alto rendimiento como vLLM y Ollama.
La propuesta pedagógica combina análisis riguroso de principios de diseño con código Python reproducible y estudios de casos centrados en resolver los fallos habituales de la puesta en marcha empresarial. Su principal valor es su honestidad técnica: enseña a diagnosticar y contener el no determinismo de los LLMs sin vender soluciones mágicas. Queda fuera de su alcance el entrenamiento desde cero de modelos fundacionales masivos, centrándose exclusivamente en la integración, gobernanza y optimización de modelos preentrenados. Conviene contar con experiencia en pruebas de software (como pytest) y microservicios para aprovechar al máximo sus directrices.
- Evaluación de LLMs
- Evals Gap
- DeepEval
- Ragas
- RAG avanzado
- Salidas estructuradas
- Seguridad de LLMs
- Alineamiento y Red-Teaming
- vLLM
- Ollama
- Modelos Open Source
¿Cómo enseña?
Teoría + práctica
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Suite de evaluación automatizada para RAG
Pipeline de pruebas continuas con DeepEval y Ragas diseñado para auditar la precisión del contexto, fidelidad de respuestas y regresiones en sistemas generativos.
Framework de moderación, red-teaming y seguridad
Implementación práctica de barandillas de seguridad y pruebas adversariales con benchmarks como HarmBench para validar la robustez y alineamiento del modelo frente a inyecciones.