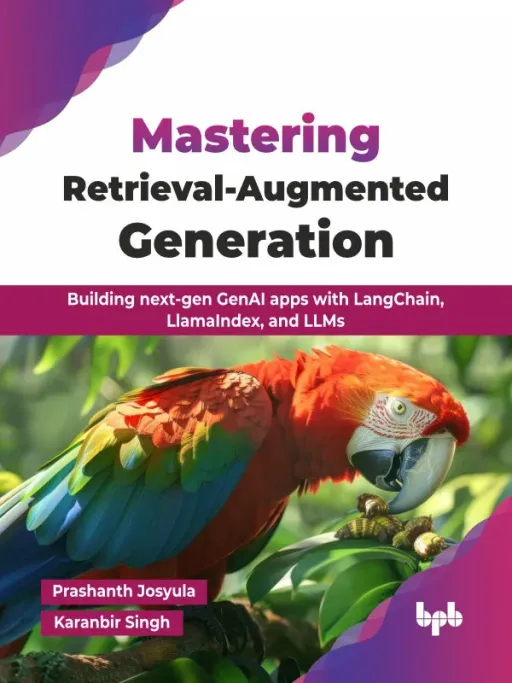
Mastering Retrieval-Augmented Generation
Josyula Prashanth, Karanbir Singh
- Editorial
- BPB
- Año
- 2025
- Páginas
- ~567
- Nivel
- Avanzado
De qué trata
"Mastering Retrieval-Augmented Generation", escrito por Prashanth Josyula y Karanbir Singh y publicado por BPB Publications en 2025, es una guía de nivel avanzado dedicada por completo a la arquitectura RAG para el desarrollo de aplicaciones generativas precisas, basadas en hechos y ancladas en datos corporativos. Está dirigida a ingenieros de IA, desarrolladores de software y arquitectos técnicos que ya dominan Python y el consumo de APIs de modelos fundacionales (como GPT, BERT o T5) y requieren eliminar alucinaciones y conectar información externa a sus modelos en entornos de producción.
El libro disecciona cada componente de la canalización RAG: estrategias de segmentación de texto (chunking), generación de representaciones vectoriales con modelos de embeddings, indexación y almacenamiento en bases de datos vectoriales (como FAISS, Chroma o Pinecone), y técnicas de reranking y enrutamiento semántico. Explica en profundidad el uso práctico de los dos entornos de desarrollo más influyentes, LangChain y LlamaIndex, comparando sus estructuras de datos, mecanismos de recuperación y patrones de integración para consultar colecciones de documentos empresariales.
A lo largo del texto se implementan sistemas de preguntas y respuestas documentales de extremo a extremo con LangChain y LlamaIndex, optimizando el contexto recuperado, evaluando la fidelidad de las respuestas y abordando la puesta en producción con consideraciones de latencia y gobernanza de datos. Su principal valor es el tratamiento exhaustivo de una técnica crítica en la industria, ofreciendo patrones claros para resolver los cuellos de botella de recuperación y precisión en aplicaciones reales. Es conveniente contar con experiencia previa en desarrollo backend y llamadas asíncronas en Python para aprovechar al máximo las implementaciones.
- Retrieval-Augmented Generation (RAG)
- LangChain
- LlamaIndex
- Bases de datos vectoriales
- Embeddings
- Modelos de lenguaje grandes (LLMs)
- Chunking semántico
- Reranking
- Mitigación de alucinaciones
- Despliegue en producción
¿Cómo enseña?
Con proyectos
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Pipeline RAG integral con LangChain
Construcción de un sistema de preguntas y respuestas sobre documentación técnica que procesa textos, almacena embeddings en una base vectorial y sintetiza respuestas con LLMs.
Motor de búsqueda y recuperación avanzada con LlamaIndex
Implementación de un flujo de indexación estructurada con LlamaIndex que integra filtrado semántico, reranking y optimización de contexto para consultas en corpus corporativos.