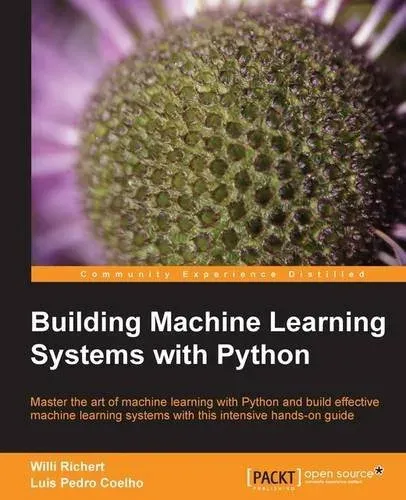
Building Machine Learning Systems with Python
Luis Pedro Coelho, Willi Richert
- Editorial
- Packt
- Año
- 2013
- Páginas
- ~290
- Nivel
- Intermedio
De qué trata
Manual práctico de Luis Pedro Coelho y Willi Richert concebido para enseñar machine learning a través de la construcción de sistemas completos con datos del mundo real, en lugar de centrarse en derivaciones matemáticas abstractas. Enmarcado en el entorno de Python 2.7 y el inicio del estándar científico de Scikit-learn, el libro está dirigido a programadores y científicos de datos noveles con conocimientos básicos de Python que quieren aprender a limpiar datos heterogéneos, extraer características significativas y poner a punto modelos predictivos.
El contenido abarca el espectro clásico del machine learning: regresión lineal y penalizada (Lasso y ElasticNet), clasificación supervisada (regresión logística, Naive Bayes), agrupamiento no supervisado (K-Means), modelado de tópicos probabilísticos mediante asignación latente de Dirichlet (LDA), reducción de dimensionalidad (PCA) y filtrado colaborativo para sistemas de recomendación. Las librerías y herramientas utilizadas incluyen Scikit-learn, NumPy, SciPy, Gensim para modelado de texto, Mahotas para procesamiento digital de imágenes y visión artificial, junto con conceptos de computación concurrente con Jug/Multiprocessing y despliegues en Amazon Web Services (AWS).
El aprendizaje es totalmente práctico y guiado por casos reales: agrupamiento de preguntas similares en foros como Stack Overflow, detección de respuestas de baja calidad, análisis de sentimiento de publicaciones en Twitter, catalogación de géneros musicales analizando audio con la Transformada Rápida de Fourier (FFT), filtrado de imágenes y recomendaciones de compra. Su mayor virtud es inculcar la mentalidad analítica del científico de datos frente a datos ruidosos e imperfectos. Al pertenecer a 2013, deja fuera frameworks contemporáneos de deep learning (como PyTorch o TensorFlow) y la sintaxis moderna de Python 3, por lo que ciertos paquetes requieren adaptación en entornos actuales.
- Scikit-learn
- NumPy
- SciPy
- Gensim
- Mahotas
- Transformada de Fourier (FFT)
- Procesamiento de Lenguaje Natural
- Modelado de tópicos (LDA)
- Sistemas de recomendación
- Visión por computador
¿Cómo enseña?
Con proyectos
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Clasificador de géneros musicales por análisis de audio WAV
Sistema que descompone archivos de audio en frecuencias mediante la Transformada Rápida de Fourier (FFT) y entrena modelos con Scikit-learn para clasificar canciones en géneros musicales.
Detector de respuestas de baja calidad en Stack Overflow
Modelo de clasificación basado en regresión logística que evalúa atributos de texto y metadatos para identificar y moderar automáticamente respuestas deficientes en foros técnicos.
Modelador de temas en grandes corpus con LDA y Gensim
Pipeline de procesamiento de texto a gran escala que procesa artículos de Wikipedia para descubrir y agrupar tópicos semánticos latentes utilizando Gensim.
Motor de recomendación y análisis de cesta de la compra
Implementación de algoritmos de filtrado colaborativo vecinal y minería de reglas de asociación sobre transacciones para predecir compras y recomendar artículos afines.