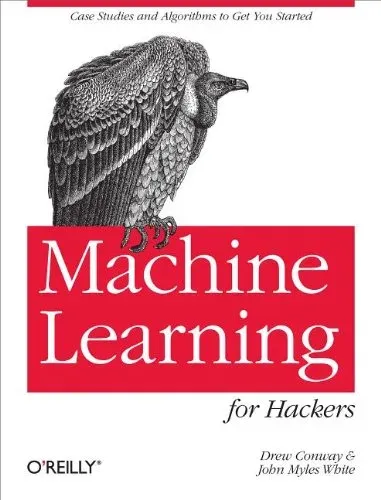
Machine Learning for Hackers
Drew Conway, John Myles White
- Editorial
- O'Reilly
- Año
- 2012
- Páginas
- ~324
- Nivel
- Básico
De qué trata
Obra introductoria y metodológica que enseña aprendizaje automático a través de estudios de caso concretos y resolución de problemas prácticos guiados por código, dirigida a quienes adoptan una mentalidad de hacker o artesano del software. Publicada a inicios de 2012 por Drew Conway y John Myles White, utiliza como base el lenguaje estadístico R (versión 2.14 / 2.x) y está pensada para desarrolladores y analistas de datos principiantes o intermedios que buscan aprender algoritmos de machine learning mediante la experimentación directa en lugar de partir de demostraciones matemáticas rigurosas.
El recorrido abarca la manipulación de datos y visualización estadística con librerías como ggplot2 y plyr, clasificación probabilística con Naive Bayes, modelos de regresión lineal simple y múltiple, técnicas de regularización (Ridge y Lasso con el paquete glmnet), algoritmos de optimización estocástica (método de Monte Carlo por cadenas de Markov mediante el algoritmo Metropolis-Hastings), reducción de dimensiones con Análisis de Componentes Principales (PCA) y Escalamiento Multidimensional (MDS), sistemas de recomendación con el algoritmo k-Nearest Neighbors (k-NN) a través del paquete class, análisis de redes sociales y detección de comunidades con igraph, y validación cruzada y comparación de modelos con matrices de confusión y curvas ROC.
Cada capítulo desarrolla un proyecto temático completo con datos reales: un clasificador de correo no deseado con SpamAssassin, un organizador de bandeja de entrada prioritaria, un predictor de tráfico web sobre las páginas más visitadas de internet, un descifrador de códigos criptográficos por sustitución, un índice bursátil sintético con PCA, un mapa de proximidad ideológica de senadores estadounidenses mediante MDS, un motor de recomendación de cuentas de Twitter con k-NN y el análisis estructural de comunidades en redes sociales. El libro destaca por su creatividad pedagógica y su capacidad para desmitificar algoritmos complejos con ejemplos lúdicos e intuitivos; no obstante, el código utiliza convenciones de R anteriores al ecosistema moderno de tidyverse, carece de cobertura de deep learning y ciertas fuentes de datos o APIs de la época ya no están vigentes.
- R
- ggplot2
- Naive Bayes
- Regresión lineal
- Regularización
- PCA
- k-NN
- Sistemas de recomendación
- Análisis de redes sociales
- igraph
- Optimización estocástica
¿Cómo enseña?
Con proyectos
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Filtro de correo no deseado con Naive Bayes
Clasificador de texto que procesa mensajes del corpus de SpamAssassin en R para categorizar automáticamente correos en spam o legítimos según frecuencias de palabras.
Bandeja de entrada prioritaria (Priority Inbox)
Módulo de ordenación de correos que pondera remitentes e interacciones en hilos de mensajes para destacar los correos más relevantes en R.
Predictor de tráfico web
Modelo de regresión lineal en R entrenado sobre los 1.000 sitios web más visitados para estimar visualizaciones de página a partir de variables de tráfico.
Descifrador de textos por optimización estocástica
Herramienta criptográfica que resuelve cifrados de sustitución simple modelando la frecuencia de letras y optimizando con el algoritmo Metropolis-Hastings en R.
Índice financiero sintético con PCA
Aplicación de Análisis de Componentes Principales en R sobre series temporales de acciones del mercado de valores para construir un índice representativo de mercado.
Visualizador de similitud política entre senadores con MDS
Análisis y representación visual en dos dimensiones mediante Escalamiento Multidimensional (MDS) del historial de votaciones del Senado de los Estados Unidos.
Recomendador de usuarios de Twitter con k-NN
Motor de recomendación de cuentas a seguir basado en matrices de afinidad e intereses mutuos empleando el algoritmo k-Nearest Neighbors en R.
Analizador de grafos y comunidades en redes sociales
Mapeo y detección de agrupaciones y métricas de centralidad sobre estructuras relacionales de redes sociales utilizando el paquete igraph en R.