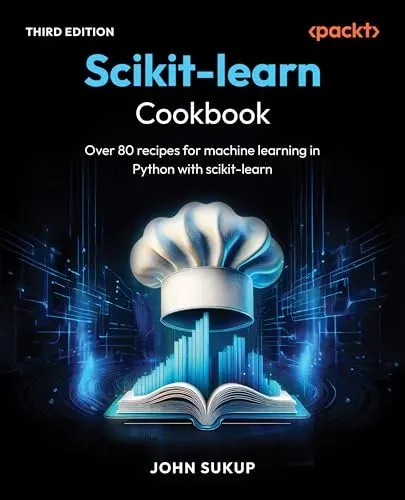
scikit-learn Cookbook, 3rd Edition
John Sukup
- Editorial
- Packt
- Año
- 2025
- Páginas
- ~388
- Nivel
- Intermedio
De qué trata
Manual técnico en formato de recetario práctico escrito por John Sukup y actualizado para aprovechar todas las novedades y mejoras de rendimiento de scikit-learn 1.5 en entornos de Python 3. Está pensado para científicos de datos, ingenieros de machine learning y programadores de nivel intermedio que ya entienden la teoría elemental de los modelos predictivos y necesitan patrones de código listos para producción, reproducibles y eficientes para su día a día laboral.
El volumen reúne más de 80 recetas estructuradas que cubren todo el espectro de la biblioteca: convenciones de la API y creación de estimadores y transformadores personalizados; preprocesamiento avanzado, escalado e imputación; técnicas modernas de reducción de dimensionalidad con PCA; modelos lineales y variantes regularizadas (Ridge, Lasso, ElasticNet); regresión logística multiclase; Support Vector Machines (SVM) con funciones de kernel; algoritmos basados en árboles y ensambles (Random Forest, Gradient Boosting); vectorización y análisis de texto mediante TF-IDF; clustering no supervisado; detección de anomalías y novedades con Isolation Forest; y esquemas rigurosos de validación cruzada y evaluación de métricas.
Cada sección sigue la clásica estructura de recetario («cómo hacerlo» y «cómo funciona»), facilitando soluciones independientes a problemas específicos sin obligar a implementar un proyecto monolítico, concluyendo con un capítulo dedicado al empaquetado, serialización y despliegue de modelos en entornos productivos. Su gran ventaja es la frescura y elegancia de los pipelines de datos automatizados conforme a los estándares actuales de scikit-learn; por diseño, deja fuera arquitecturas de deep learning (PyTorch o TensorFlow) y procesamiento distribuido masivo, consolidándose como un manual de consulta inmediata sumamente práctico.
- Python 3
- scikit-learn 1.5
- Pipelines
- Preprocesamiento de datos
- Reducción de dimensionalidad
- Modelos lineales
- Support Vector Machines
- Ensemble Learning
- Procesamiento de texto
- Detección de anomalías
- Validación cruzada
- Despliegue de modelos
¿Cómo enseña?
Con ejercicios
- ✓ Incluye ejercicios
- ✗ Sin proyectos