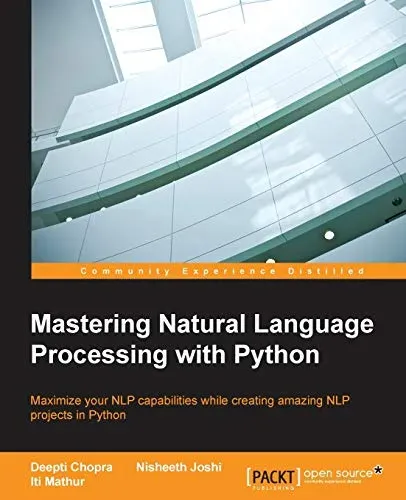
Mastering Natural Language Processing with Python
Deepti Chopra, Iti Mathur, Nisheeth Joshi
- Editorial
- Packt
- Año
- 2016
- Páginas
- ~238
- Nivel
- Avanzado
De qué trata
Manual avanzado publicado por Packt que explora los fundamentos teóricos y algorítmicos del procesamiento del lenguaje natural clásico y estadístico mediante Python (compatible con las versiones 2.7 y 3.x) y la biblioteca NLTK (Natural Language Toolkit). Está dirigido a programadores de Python, científicos de datos e investigadores con un nivel intermedio o avanzado que ya dominan el lenguaje y desean profundizar en la mecánica lingüística y computacional que sustenta el análisis de texto antes de la adopción masiva del deep learning.
El contenido desglosa en detalle las fases tradicionales de un pipeline de NLP: correspondencia y normalización de cadenas, modelos probabilísticos y estadísticos de lenguaje basados en n-gramas, y desarrollo de analizadores y generadores morfológicos para derivación (stemming) y lematización. Aborda en profundidad el etiquetado gramatical (POS tagging), la estructuración sintáctica con gramáticas libres de contexto (CFG) y Treebanks, y algoritmos de parsing como CYK (Cocke-Younger-Kasami) y Earley Chart Parsing. En el plano semántico y discursivo, enseña a utilizar WordNet para desambiguación léxica (WSD), reconocimiento de entidades nombradas (NER), análisis de sentimientos, resumen automático de documentos, recuperación de información y resolución de anáforas.
El libro guía la implementación progresiva de varios componentes prácticos, incluyendo un motor de indexación y búsqueda básica de texto, un pipeline de resumen extractivo y un prototipo de sistema de preguntas y respuestas basado en análisis sintáctico. Su mayor valor reside en enseñar cómo funcionan internamente los algoritmos lingüísticos que las librerías modernas suelen ocultar como cajas negras; por otro lado, al haberse publicado en 2016, no cubre embeddings densos modernos (Word2Vec, BERT o Transformers) ni arquitecturas neuronales. Es una obra idónea para asentar una base teórica y algorítmica rigurosa en lingüística computacional.
- Python
- NLTK
- Modelos de lenguaje estadísticos
- POS Tagging
- Parsing sintáctico (CYK y Earley)
- Gramáticas libres de contexto (CFG)
- WordNet
- Named Entity Recognition (NER)
- Resumen automático de texto
- Análisis de sentimientos
- Sistemas de preguntas y respuestas
¿Cómo enseña?
Teoría + práctica
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Motor de búsqueda y recuperación de información
Sistema de indexación y consulta léxica basado en modelos de n-gramas y correspondencia de patrones para localizar documentos relevantes con NLTK.
Pipeline de preguntas y respuestas basado en sintaxis
Módulo que analiza gramaticalmente la consulta del usuario mediante árboles de parsing y extrae entidades para determinar y devolver la respuesta adecuada.
Resumidor extractivo de textos
Herramienta que procesa textos extensos, analiza frecuencias léxicas y oracionales, y extrae las frases estadísticamente más representativas para crear un resumen.