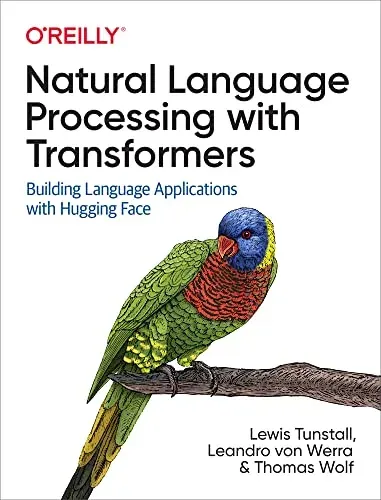
Natural Language Processing with Transformers
Lewis Tunstall, Leandro von Werra, Thomas Wolf
- Editorial
- O'Reilly
- Año
- 2022
- Páginas
- ~570
- Nivel
- Intermedio
De qué trata
Guía práctica y rigurosa sobre la arquitectura Transformer y su aplicación al procesamiento del lenguaje natural mediante el ecosistema de Hugging Face. Escrita directamente por ingenieros e investigadores nucleares de Hugging Face —incluyendo a Thomas Wolf, cofundador y Chief Science Officer de la plataforma—, la obra está dirigida a científicos de datos, ingenieros de machine learning y desarrolladores con un nivel intermedio que ya dominan Python y poseen nociones fundamentales de aprendizaje profundo con PyTorch.
El texto desglosa en profundidad las librerías centrales del ecosistema Hugging Face (Transformers, Datasets, Tokenizers, Accelerate y Hugging Face Hub), complementadas con Haystack de deepset, PyTorch, ONNX Runtime y Optuna. Enseña a implementar las principales tareas de PLN: clasificación de secuencias, extracción de entidades nombradas (NER) multilingüe, generación de texto mediante muestreo y decodificación por haz, resumen abstracto de documentos y respuesta a preguntas (QA) extractiva. Además, aborda técnicas críticas de optimización para producción como destilación de conocimiento, cuantización, poda y estrategias para escenarios con pocos o ningún dato etiquetado (zero-shot y few-shot learning).
A lo largo de sus capítulos se desarrollan proyectos de extremo a extremo, tales como un clasificador de emociones a partir de tweets con DistilBERT, un sistema NER multilingüe con XLM-RoBERTa, un motor de búsqueda y respuesta a preguntas con Haystack y el entrenamiento desde cero de CodeParrot, un modelo GPT-2 adaptado a código Python de GitHub. Constituye el manual de referencia definitivo para dominar la librería Transformers en proyectos reales; no obstante, requiere acceso a GPU para replicar los entrenamientos pesados y asume soltura matemática básica con tensores y arquitecturas neuronales.
- Transformers
- Hugging Face
- PyTorch
- Tokenizers
- Datasets
- Clasificación de texto
- NER multilingüe
- Resumen automático
- Question Answering
- Optimización y cuantización
- Generación de código
¿Cómo enseña?
Con proyectos
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Clasificador de emociones en texto
Pipeline de clasificación multiclase sobre tweets utilizando DistilBERT y Hugging Face Trainer, con análisis detallado de errores y métricas de rendimiento.
Extractor multilingüe de entidades nombradas
Modelo de Named Entity Recognition entrenado con XLM-RoBERTa sobre el corpus multilingüe PAN-X para detectar entidades en múltiples idiomas.
Motor de búsqueda y respuesta a preguntas con Haystack
Sistema end-to-end de Question Answering basado en una arquitectura retriever-reader que integra Elasticsearch y Transformers para responder preguntas sobre opiniones de clientes.
CodeParrot: modelo de generación de código
Entrenamiento desde cero de un modelo de lenguaje autorregresivo tipo GPT-2 especializado en autocompletar código Python a partir de millones de repositorios de GitHub.