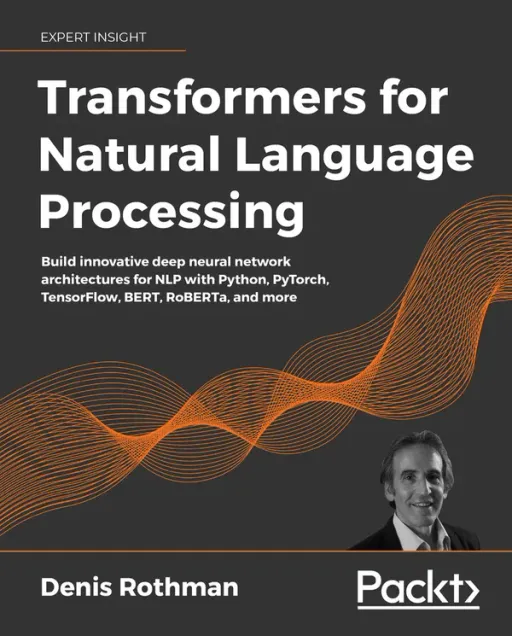
Transformers for Natural Language Processing
Denis Rothman
- Editorial
- Packt
- Año
- 2021
- Páginas
- ~493
- Nivel
- Intermedio
De qué trata
Publicado a principios de 2021 por Packt, este libro de Denis Rothman aborda el cambio fundamental de paradigma en el procesamiento del lenguaje natural: la transición desde redes neuronales recurrentes (RNN, LSTM) y convolucionales hacia arquitecturas basadas en autoatención derivadas del influyente artículo 'Attention Is All You Need'. La obra trabaja con Python, PyTorch, TensorFlow 2 y el ecosistema inicial de Hugging Face Transformers. Está concebida para desarrolladores de software, científicos de datos e ingenieros de machine learning de nivel intermedio que ya dominan los fundamentos de deep learning y álgebra matricial, pero buscan adentrarse en la mecánica interna de los modelos Transformer.
El contenido disecciona la arquitectura original codificador-decodificador y profundiza en modelos icónicos como BERT, RoBERTa, DistilBERT, T5, GPT-2 y los primeros conceptos asociados a GPT-3. Enseña a manipular tokenizadores a nivel de subpalabras (como Byte-Pair Encoding y WordPiece), a gestionar conjuntos de datos y pipelines de entrenamiento, y a resolver tareas prácticas de comprensión (NLU) y generación (NLG) de texto: análisis de sentimientos, traducción automática neuronal con Google Trax, etiquetado de roles semánticos (SRL) con AllenNLP, resumen automático de documentos extensos y detección de noticias falsas. Además, incluye técnicas de interpretabilidad y visualización de atención mediante herramientas como BertViz.
A lo largo de sus cuadernos de Google Colab se practican pipelines guiados, destacando la construcción y preentrenamiento desde cero de un modelo de lenguaje enmascarado propio bautizado como 'KantaiBERT' (usando textos de Immanuel Kant y un tokenizador BPE personalizado). Su gran aportación radica en mostrar el funcionamiento matemático y estructural 'bajo el capó' de los Transformers sin limitarse a consumir APIs de alto nivel. Quedan fuera los avances de modelos de instrucciones masivos posteriores (ChatGPT, GPT-4) y modelos multimodales contemporáneos, pero constituye una base técnica sólida y rigurosa para entender de dónde proviene la revolución de la IA generativa actual.
- Transformers
- Mecanismos de autoatención
- BERT
- RoBERTa
- GPT-2
- Hugging Face
- PyTorch
- TensorFlow
- Google Trax
- BertViz
- Google Colab
- Procesamiento del lenguaje natural
¿Cómo enseña?
Teoría + práctica
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
KantaiBERT: preentrenamiento de RoBERTa desde cero
Construcción, tokenización personalizada con ByteLevelBPETokenizer y preentrenamiento de un modelo de lenguaje enmascarado (MLM) compacto basado en RoBERTa utilizando textos de dominio filosófico en PyTorch y Hugging Face.
Pipeline de traducción automática con Google Trax
Implementación de una arquitectura Transformer secuencia a secuencia para tareas de traducción lingüística utilizando el framework de alto rendimiento Trax en Google Colab.
Extractor y sintetizador de documentos con T5 y GPT-2
Canal de procesamiento y resumen de contratos legales y reportes financieros complejos aprovechando modelos preentrenados y tuberías de Hugging Face.