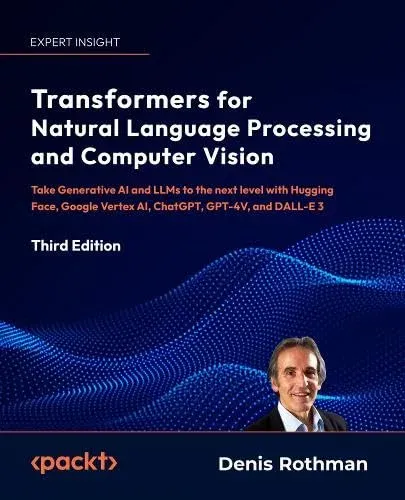
Transformers for Natural Language Processing and Computer Vision
Denis Rothman
- Editorial
- Packt
- Año
- 2024
- Páginas
- ~1121
- Nivel
- Intermedio
De qué trata
En su tercera edición, publicada en febrero de 2024 con más de 1100 páginas, Denis Rothman transforma su guía clásica en una referencia monumental que unifica el procesamiento de lenguaje natural y la visión por computadora mediante arquitecturas Transformer. La obra abarca Python 3, PyTorch 2.x, las librerías modernas de Hugging Face, modelos multimodales, APIs de OpenAI (ChatGPT, GPT-4, GPT-4V, DALL-E 3) y la plataforma Google Cloud Vertex AI (PaLM 2 / Gemini). Está dirigida a desarrolladores, científicos de datos y arquitectos de soluciones de nivel intermedio a avanzado que necesitan dominar tanto los modelos masivos de lenguaje (LLMs) como los modelos generativos de visión y agentes de IA.
El temario cubre desde los cimientos de la atención multicabezal y el preentrenamiento de modelos base como RoBERTa, hasta el ajuste fino (fine-tuning) de modelos GPT, el uso eficiente de representaciones vectoriales (embeddings) como alternativa al reentrenamiento y técnicas de mitigación de alucinaciones en LLMs. En el plano visual y multimodal, enseña Vision Transformers (ViT), modelos de difusión (Stable Diffusion) y alineación texto-imagen con CLIP, la creación de modelos de visión sin código con Hugging Face AutoTrain, y la orquestación de sistemas de agentes multifunción mediante HuggingGPT. También presta especial atención a la gobernanza, ética e interpretabilidad con herramientas como LIME, SHAP y BertViz.
El libro contiene un amplio repertorio práctico implementado en notebooks de Google Colab, que incluye desde agentes coordinadores hasta generación de imágenes guiadas por texto y evaluación de riesgos en entornos empresariales. Su valor reside en su extraordinaria amplitud temática y en la actualización exhaustiva hacia la IA generativa multimodal contemporánea. Conviene tener presente que el aprovechamiento de varios capítulos requiere cuentas y créditos en servicios de pago como OpenAI y Google Cloud Vertex AI, además de cierta potencia de cálculo en GPU para los modelos locales.
- Transformers
- Grandes modelos de lenguaje (LLM)
- Vision Transformers (ViT)
- OpenAI GPT-4
- Hugging Face
- Stable Diffusion
- CLIP
- Google Vertex AI
- HuggingGPT
- IA multimodal
- Interpretabilidad (SHAP/LIME)
- Mitigación de riesgos de IA
¿Cómo enseña?
Teoría + práctica
- ✓ Incluye ejercicios
- ✓ Incluye proyectos
Proyectos
Pipeline multimodal de generación con Stable Diffusion y CLIP
Flujo de síntesis y edición de imágenes a partir de descripciones textuales complejas, combinando Vision Transformers, alineación semántica CLIP y modelos de difusión en PyTorch.
Orquestación de agentes autónomos con HuggingGPT
Construcción de un sistema donde un modelo de lenguaje actúa como planificador maestro para delegar tareas multimodales (visión, voz, texto) a modelos especializados de la comunidad de Hugging Face.
Alineación y mitigación de alucinaciones en LLMs comerciales
Diseño de un entorno de control y guardarraíles para modelos OpenAI y Vertex AI, combinando reglas semánticas y verificación de hechos para reducir sesgos y salidas erróneas.