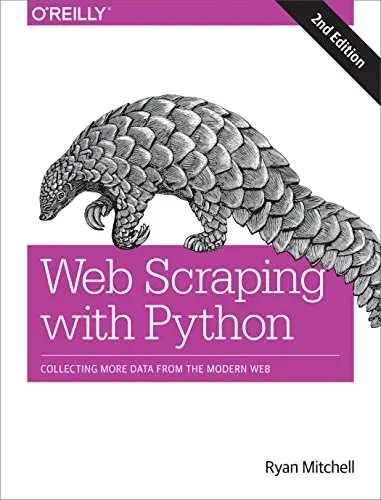
Web Scraping with Python, 2nd Edition
Ryan Mitchell
- Editorial
- O'Reilly
- Año
- 2018
- Páginas
- ~308
- Nivel
- Intermedio
De qué trata
Segunda edición del tratado canónico sobre extracción automatizada de datos en la web escrito por Ryan Mitchell y publicado por O'Reilly en 2018. Enseña a extraer información estructurada a gran escala de internet.
Aborda el análisis de HTML/XML con BeautifulSoup y lxml, rastreo avanzado con Scrapy, renderizado de JavaScript dinámico con Selenium, lectura de PDFs e imágenes con reconocimiento óptico de caracteres (Tesseract OCR), y almacenamiento de datos.
Ryan Mitchell combina instrucciones técnicas precisas con reflexiones sobre ética, legalidad y respeto a las directivas `robots.txt` y límites de tasa (rate limiting). La referencia definitiva sobre web scraping en Python.
- Web Scraping
- Scrapy
- BeautifulSoup
- Selenium
- OCR Tesseract
- Ryan Mitchell
- O'Reilly
¿Cómo enseña?
Con proyectos
- ✓ Incluye ejercicios
- ✓ Incluye proyectos
Proyectos
Crawler Web Distribuido con Scrapy y Extracción OCR
Construcción de un rastreador que extrae datos de catálogos dinámicos y analiza texto incrustado en imágenes documentales.