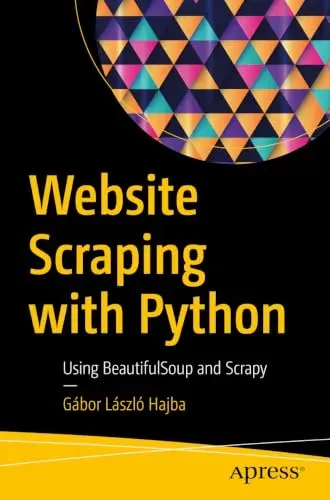
Website Scraping with Python
Gábor László Hajba
- Editorial
- Apress
- Año
- 2018
- Páginas
- ~223
- Nivel
- Intermedio
De qué trata
Manual práctico sobre extracción y recolección automatizada de datos en la web escrito por Gábor László Hajba y publicado por Apress en 2018. Enseña a extraer información estructurada de páginas web respetando principios de ética y rendimiento.
Aborda el protocolo HTTP, inspección del DOM con BeautifulSoup y lxml, navegación interactiva y renderizado de páginas dinámicas con Selenium, gestión de sesiones y cookies, y almacenamiento de datos extraídos en CSV, JSON y bases de datos relacionales.
Gábor László Hajba guía al lector en la resolución de problemas reales como navegación con JavaScript dinámico, manejo de límites de peticiones (rate limiting) y evasión de bloqueos básicos. Muy útil para analistas e ingenieros de datos.
- Web Scraping
- BeautifulSoup
- Selenium
- lxml
- Extracción de Datos
- Apress
¿Cómo enseña?
Con proyectos
- ✓ Incluye ejercicios
- ✓ Incluye proyectos
Proyectos
Rastreador Web de Inmuebles con Exportación Estructurada
Construcción de un scraper automatizado con BeautifulSoup y Selenium para consolidar listados inmobiliarios en base de datos.