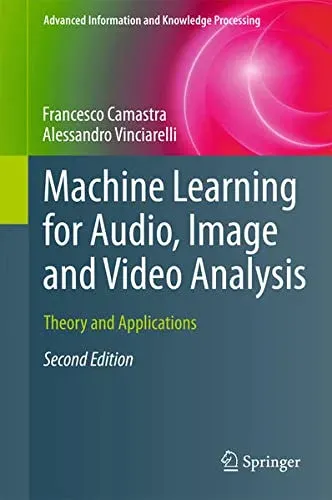
Machine Learning for Audio, Image and Video Analysis, 2nd Edition
Alessandro Vinciarelli, Francesco Camastra
- Editorial
- Springer
- Año
- 2015
- Páginas
- ~580
- Nivel
- Intermedio
De qué trata
Tratado académico riguroso que formaliza los fundamentos matemáticos y computacionales del aprendizaje automático aplicado a las tres fuentes de datos perceptuales clave: audio, imágenes fijas y secuencias de video. Publicado en su segunda edición dentro de la serie de información avanzada de Springer, el texto está concebido para estudiantes de posgrado, investigadores y desarrolladores especializados en procesamiento de señales que dispongan de una base sólida en cálculo multivariable, álgebra lineal y teoría de probabilidades.
La obra se divide en tres bloques bien diferenciados: percepción y adquisición de señales, metodologías de aprendizaje automático y aplicaciones prácticas. Enseña a extraer descriptores acústicos (como coeficientes cepstrales en la escala de Mel o MFCC y análisis de Fourier) y representaciones visuales digitales (espacios de color, filtrado espacial, gradientes y flujo óptico). En el plano algorítmico, profundiza en la teoría de decisión bayesiana, clustering (k-means y métodos espectrales), máquinas de vectores de soporte (SVM) y métodos de kernel, redes neuronales supervisadas (perceptrones multicapa y funciones de base radial), modelos de ensamble (AdaBoost), modelos ocultos de Markov (HMM) para datos secuenciales y reducción de dimensionalidad con técnicas de Manifold Learning (PCA, LDA, LLE e ISOMAP).
En su sección aplicada, analiza problemas representativos como el reconocimiento automático de voz, el reconocimiento óptico de escritura manuscrita, la identificación facial biométrica, la segmentación temporal de secuencias de video con extracción de fotogramas clave y el reconocimiento de gestos de manos en tiempo real. Su valor radica en la unificación matemática entre el procesamiento digital de señales perceptuales y los clasificadores estadísticos; no obstante, al haber sido publicado en 2015, deja fuera los avances contemporáneos del aprendizaje profundo basados en redes neuronales profundas y mecanismos de atención. Resulta indispensable como obra de consulta teórica para comprender el funcionamiento interno de los algoritmos clásicos de visión y audio.
- Procesamiento de audio
- Procesamiento de video
- Visión por computadora
- Extracción de características
- MFCC
- Support Vector Machines (SVM)
- Modelos Ocultos de Markov (HMM)
- Redes Neuronales
- Clustering
- Manifold Learning
- Reconocimiento de voz
- Reconocimiento facial
¿Cómo enseña?
Teórico
- ✓ Incluye ejercicios
- ✗ Sin proyectos