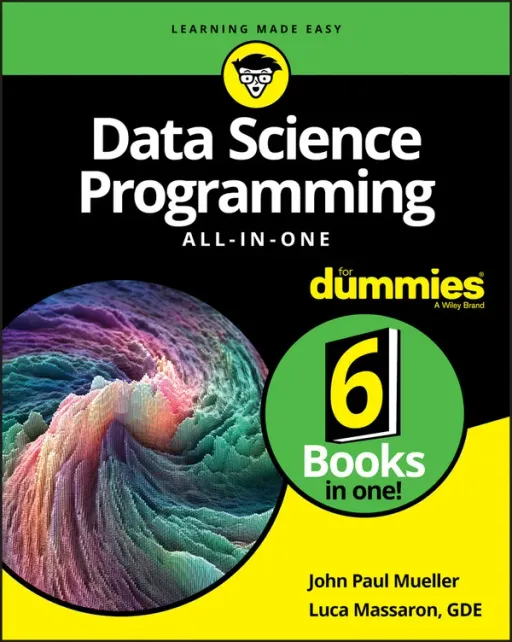
Data Science Programming All-In-One For Dummies
John Paul Mueller, Luca Massaron
- Editorial
- Wiley
- Año
- 2020
- Páginas
- ~768
- Nivel
- Básico
De qué trata
Compendio enciclopédico de referencia para principiantes estructurado en seis minilibros, escrito por John Paul Mueller y Luca Massaron para introducir las dos herramientas esenciales de la disciplina: Python (versión 3.x) y R (versión 3.6/4.x). Está diseñado desde cero para aficionados, estudiantes, analistas de negocio y programadores noveles sin experiencia previa en estadística ni matemáticas avanzadas, facilitando la instalación de entornos analíticos modernos (como la distribución Anaconda, Jupyter Notebook y RStudio) para comenzar a explorar datos de inmediato.
A lo largo de sus seis módulos, la obra cubre exhaustivamente el ciclo analítico: almacenamiento y extracción de datos (archivos CSV, JSON, bases de datos SQL, web scraping con Beautiful Soup y consumo de APIs), manipulación y análisis estadístico elemental (mediante NumPy, Pandas y Scikit-learn en Python, junto con librerías base y dplyr en R), algoritmos de machine learning (regresión lineal, regresión logística y agrupamiento con k-means), técnicas avanzadas de ensambles (árboles de decisión, Random Forest, AdaBoost, Gradient Boosting) e introducción al aprendizaje profundo con TensorFlow y Keras. Además, aborda casos de uso especializados como sistemas de recomendación mediante descomposición en valores singulares (SVD) y clasificación de imágenes mediante redes neuronales convolucionales (CNN), finalizando con un minilibro dedicado al diagnóstico, calidad de datos y depuración de errores de código.
El libro plantea multitud de ejemplos y pequeños proyectos guiados, como la construcción de un motor de recomendación de elementos, un clasificador visual de imágenes con deep learning y tareas de extracción automatizada de datos web. Su gran fortaleza es la comparación directa entre Python y R, permitiendo al lector evaluar qué lenguaje se ajusta mejor a cada fase del problema sin necesidad de adquirir volúmenes separados. Deja fuera la ingeniería de datos a nivel de clúster distribuido (como Spark o Hadoop) y despliegues productivos complejos en contenedores o en la nube. Es un recurso accesible, paciente y muy completo para asentar cimientos firmes en la ciencia de datos.
- Python 3
- R
- Anaconda
- Jupyter Notebook
- Pandas
- NumPy
- Scikit-learn
- TensorFlow
- Keras
- Machine Learning
- Sistemas de recomendación
- Depuración de datos
¿Cómo enseña?
Teoría + práctica
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Sistema de recomendación de elementos
Motor de filtrado colaborativo basado en la descomposición en valores singulares (SVD) para generar sugerencias personalizadas a partir de matrices de preferencias de usuarios.
Clasificador de imágenes con redes convolucionales
Modelo de aprendizaje profundo implementado con TensorFlow y Keras para el preprocesamiento y la clasificación automática de imágenes digitales.