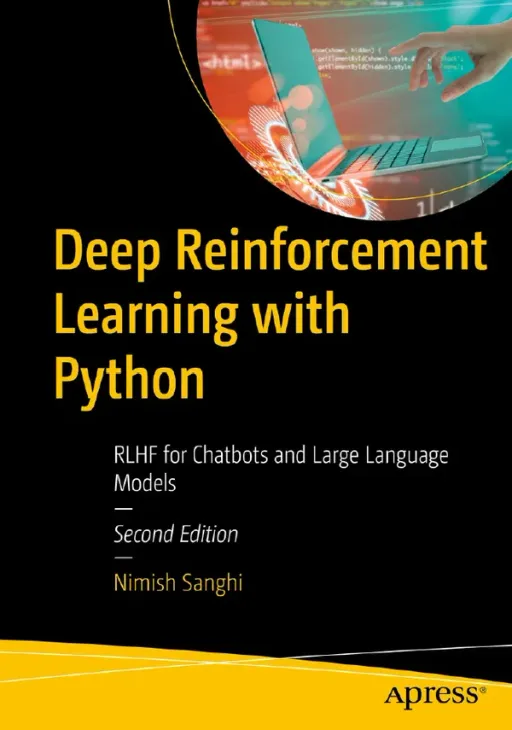
Deep Reinforcement Learning with Python, 2nd Edition
Nimish Sanghi
- Editorial
- Apress
- Año
- 2024
- Páginas
- ~650
- Nivel
- Intermedio
De qué trata
Segunda edición actualizada a 2024 de la obra de Nimish Sanghi publicada por Apress, enfocada en el aprendizaje por refuerzo profundo (Deep RL) con Python y ampliada de manera significativa para cubrir el alineamiento de modelos de lenguaje grandes (LLMs) mediante RLHF. Está dirigida a desarrolladores, científicos de datos e ingenieros de machine learning de nivel intermedio que posean bases sólidas en programación con Python, cálculo multivariable, álgebra lineal y fundamentos de aprendizaje profundo (redes neuronales y optimización por gradiente).
El texto parte de los fundamentos matemáticos de los procesos de decisión de Markov (MDP), las ecuaciones de Bellman y la programación dinámica, para luego avanzar hacia métodos libres de modelo como Monte Carlo, SARSA y Q-Learning. Posteriormente integra redes neuronales profundas y analiza arquitecturas como Deep Q-Networks (DQN), Double DQN, Dueling DQN y Prioritized Experience Replay, junto con métodos de gradiente de política como REINFORCE, Actor-Critic (A2C) y Proximal Policy Optimization (PPO). En sus capítulos más avanzados cubre entornos multiagente (MARL) y la mecánica de Reinforcement Learning from Human Feedback (RLHF), apoyándose en librerías y herramientas modernas del ecosistema como PyTorch, Gymnasium, Stable-Baselines3, PettingZoo (para multiagente), Hugging Face Hub, Weights & Biases y Google Colab.
A lo largo de sus más de 600 páginas se implementan agentes para simular entornos de control de Gymnasium (como CartPole y LunarLander) y se desarrolla un flujo completo de ajuste de instrucciones mediante RLHF y PPO para chatbots y modelos generativos. Su mayor virtud radica en unir un tratamiento teórico riguroso con código contemporáneo aplicable a la IA generativa actual. Deja fuera el despliegue a gran escala en infraestructura distribuida o sistemas embebidos, por lo que es esencial llegar con soltura en PyTorch para asimilar el ritmo de la obra.
- Deep Reinforcement Learning
- PyTorch
- RLHF
- Gymnasium
- PPO
- DQN
- Modelos de Lenguaje
- Multi-Agent RL
- Hugging Face
- Ecuaciones de Bellman
¿Cómo enseña?
Teoría + práctica
- ✓ Incluye ejercicios
- ✓ Incluye proyectos
Proyectos
Agente autónomo para entornos de simulación (Gymnasium)
Entrenamiento de agentes mediante algoritmos DQN, Double DQN y Dueling DQN para resolver tareas de control y videojuegos clásicos en Gymnasium. Tecnologías: Python, PyTorch, Gymnasium.
Alineación de un modelo de lenguaje con RLHF
Pipeline de ajuste fino con retroalimentación humana que entrena un modelo de recompensa y optimiza las respuestas de un LLM mediante PPO. Tecnologías: Python, PyTorch, Hugging Face Transformers y TRL.