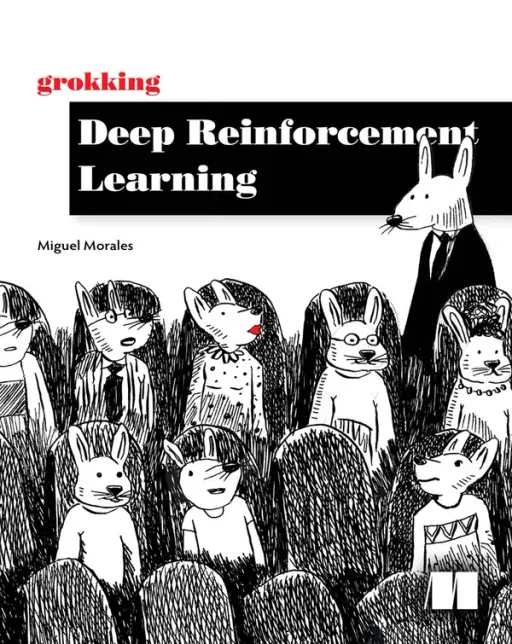
Grokking Deep Reinforcement Learning
Miguel Morales
- Editorial
- Manning
- Año
- 2020
- Páginas
- ~472
- Nivel
- Intermedio
De qué trata
Obra didáctica de referencia escrita por Miguel Morales y publicada por Manning en 2020, concebida para desglosar el aprendizaje por refuerzo profundo desde sus primeros principios matemáticos hasta los algoritmos de última generación. Mediante esquemas gráficos y explicaciones intuitivas paso a paso, el autor desmitifica la complejidad teórica del área. Está orientada a programadores, estudiantes y científicos de datos de nivel intermedio con manejo de Python y nociones elementales de probabilidad y álgebra lineal, sin asumir conocimientos previos sobre agentes inteligentes ni deep learning avanzado.
El libro aborda detalladamente los fundamentos clásicos: Procesos de Decisión de Markov (MDP), ecuaciones de Bellman, algoritmos de bandidos multibrazo y el dilema de exploración frente a explotación. Cubre con rigurosidad la programación dinámica (iteración de valor y políticas), métodos de Monte Carlo y aprendizaje por diferencias temporales (SARSA, Q-learning). Luego realiza la transición al deep learning explicando modelos basados en valor: Deep Q-Networks (DQN), Double DQN, Dueling DQN y Prioritized Experience Replay (PER). La parte final profundiza en métodos de gradiente de política y actor-crítico como REINFORCE, Advantage Actor-Critic (A2C), Generalized Advantage Estimation (GAE), Proximal Policy Optimization (PPO) y DDPG. El ecosistema técnico utiliza Python, PyTorch, OpenAI Gym, NumPy, Matplotlib y entornos reproducibles en Docker.
Se construyen de forma progresiva implementaciones completas en cuadernos de Jupyter: agentes para entornos discretos como FrozenLake, controladores de equilibrio en CartPole, sistemas de navegación lunar en LunarLander con versiones optimizadas de DQN, y controladores de acción continua para Pendulum y MountainCar empleando PPO y DDPG. La principal ventaja del libro es su claridad pedagógica y su capacidad de conectar cada ecuación con su código correspondiente. Deja fuera arquitecturas de entrenamiento masivo distribuido (como Ape-X o Ray RLLib). Resulta un texto fundamental para consolidar bases antes de abordar implementaciones industriales o investigación avanzada.
- Deep Reinforcement Learning
- PyTorch
- OpenAI Gym
- Procesos de Decisión de Markov
- Ecuación de Bellman
- Q-Learning
- Deep Q-Networks (DQN)
- Policy Gradients
- PPO
- Actor-Critic
- DDPG
¿Cómo enseña?
Teoría + práctica
- ✗ Sin ejercicios
- ✓ Incluye proyectos
Proyectos
Navegador autónomo LunarLander con DQN avanzado
Agente implementado en PyTorch y OpenAI Gym que aterriza una nave espacial en terreno irregular usando Double DQN, Dueling DQN y Prioritized Experience Replay.
Controlador de acción continua con PPO y DDPG
Modelos de actor-crítico en PyTorch para resolver tareas de control físico motor continuo (Pendulum y MountainCar) optimizando políticas sin discretizar acciones.
Simulador de exploración y toma de decisiones en FrozenLake y Bandits
Implementación desde cero de métodos de programación dinámica, Q-learning tabular y algoritmos de bandidos para resolver tareas de búsqueda de rutas y equilibrio exploración-explotación.