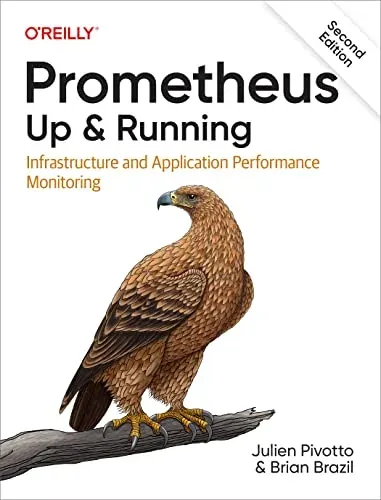
Prometheus Up & Running, 2nd Edition
Julien Pivotto, Brian Brazil
- Editorial
- O'Reilly
- Año
- 2023
- Páginas
- ~418
- Nivel
- Intermedio
De qué trata
Segunda edición de la guía de referencia autorizada sobre Prometheus publicada por O'Reilly en 2023, coescrita por Julien Pivotto (mantenedor del servidor de Prometheus) y Brian Brazil (desarrollador del núcleo de Prometheus). Está pensada para ingenieros de confiabilidad del sitio (SRE), administradores de sistemas, ingenieros de plataforma y desarrolladores de software de nivel intermedio que necesitan diseñar, implementar y operar un sistema de observabilidad y monitoreo basado en métricas para infraestructuras y aplicaciones distribuidas.
El contenido desglosa en profundidad la arquitectura interna del motor de Prometheus, su base de datos de series temporales (TSDB) y el modelo multidimensional de etiquetas (labels), prestando especial atención a cómo evitar problemas de alta cardinalidad. Enseña a instrumentar aplicaciones personalizadas utilizando las bibliotecas cliente oficiales en Go, Python y Java, a recopilar métricas de infraestructura con Node Exporter y otros exportadores comunes (Blackbox, Pushgateway), a dominar el lenguaje de consultas PromQL (incluyendo operadores de agregación, funciones matemáticas y reglas de grabación), a construir cuadros de mando interactivos en Grafana, a gestionar el ciclo de vida y enrutamiento de notificaciones con Alertmanager, y a desplegar Prometheus de forma nativa en Kubernetes con mecanismos de descubrimiento de servicios (Service Discovery).
A través de ejemplos guiados, el lector aprende a instrumentar servicios desde su código fuente, configurar la recolección automática en clústeres y establecer reglas de alerta fiables que previenen la fatiga de alertas en entornos productivos. El gran valor de esta edición radica en su rigor conceptual y en los consejos directos de sus mantenedores sobre buenas prácticas de instrumentación y seguridad en el servidor (TLS y autenticación); deja deliberadamente fuera soluciones externas de almacenamiento a largo plazo como Thanos o Cortex, manteniendo un enfoque quirúrgico y exhaustivo en el funcionamiento del propio Prometheus.
- Prometheus
- PromQL
- Grafana
- Alertmanager
- Node Exporter
- Kubernetes
- Instrumentación de código
- Go
- Python
- Series temporales
- SRE
- Observabilidad
¿Cómo enseña?
Teoría + práctica
- ✓ Incluye ejercicios
- ✓ Incluye proyectos
Proyectos
Sistema de recolección de métricas y gestión de alertas con Alertmanager
Configuración de un servidor Prometheus conectado a Node Exporter para monitorizar infraestructura host, definiendo reglas de alerta y pipelines de notificación con Alertmanager.
Instrumentación de microservicios y tableros en Kubernetes con Grafana
Integración de métricas personalizadas en aplicaciones Go y Python, desplegadas en Kubernetes con descubrimiento de servicios y dashboards de visualización en Grafana.