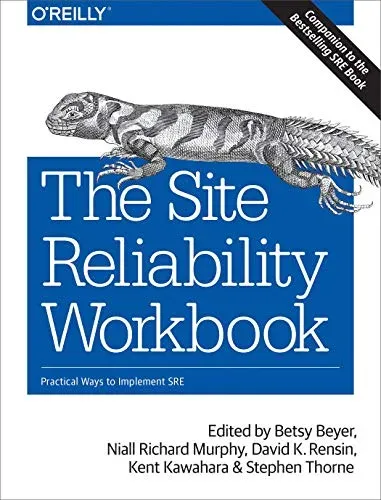
The Site Reliability Workbook
Betsy Beyer, David K. Rensin, Kent Kawahara, Niall Richard Murphy, Stephen Thorne
- Editorial
- O'Reilly
- Año
- 2018
- Páginas
- ~500
- Nivel
- Intermedio
De qué trata
Manual de referencia práctico y operativo editado por Betsy Beyer y el equipo de ingeniería de confiabilidad de sitios de Google (SRE), concebido como el complemento aplicado del célebre libro fundacional sobre SRE. Publicada por O'Reilly en 2018, la obra se enfoca en cómo implementar la ingeniería de confiabilidad en infraestructuras y servicios de cualquier tamaño, tanto dentro como fuera de la nube de Google. Está orientada a ingenieros de confiabilidad (SREs), arquitectos de sistemas, ingenieros DevOps y líderes técnicos de nivel intermedio o avanzado que cuenten con experiencia previa en operaciones, despliegue de sistemas distribuidos y monitorización de servicios.
El libro profundiza en la formulación rigurosa de Indicadores del Nivel de Servicio (SLIs), Objetivos de Nivel de Servicio (SLOs) y presupuestos de error (error budgets), enseñando cómo crear alertas predictivas basadas en tasas de consumo (burn rates) en ventanas de tiempo múltiples. Analiza de manera sistemática la eliminación del trabajo rutinario (toil), el diseño humano de rotaciones de guardia (on-call), la respuesta coordinada ante incidentes y el fomento de una cultura de autopsias sin culpables (blameless postmortems). Además, detalla el diseño de sistemas distribuidos a gran escala (NALSD - Non-Abstract Large System Design), la gestión de sobrecarga y balanceo de tráfico, la verificación de canales de procesamiento de datos y la orquestación de lanzamientos graduales tipo canario (canarying releases).
Cada capítulo incluye casos de estudio reales de empresas como The New York Times, The Home Depot y Evernote, junto con ejercicios prácticos estructurados para calcular presupuestos de error, diseñar reglas de alerta o simular desastres operativos mediante dinámicas formativas (como la «Rueda de la Infortuna»). Su mayor virtud es aterrizar los principios abstractos de Google en plantillas, fórmulas matemáticas y políticas organizacionales listas para ser adoptadas por equipos con infraestructuras heredadas. Dado que no enseña código de aplicación ni configuración de frameworks específicos, su lectura presupone un buen dominio de la arquitectura de sistemas y métricas operativas.
- Site Reliability Engineering (SRE)
- SLI y SLO
- Presupuestos de error
- Alertas multi-ventana
- Eliminación del trabajo manual (Toil)
- Gestión de guardias (On-call)
- Respuesta a incidentes
- Post-mortems sin culpa
- Diseño de sistemas a gran escala (NALSD)
- Lanzamientos tipo canario
- Casos de estudio reales
¿Cómo enseña?
Con ejercicios
- ✓ Incluye ejercicios
- ✗ Sin proyectos